Как писать SKILL.md, проверять, помогает ли он, и не поставить себе чужой вред
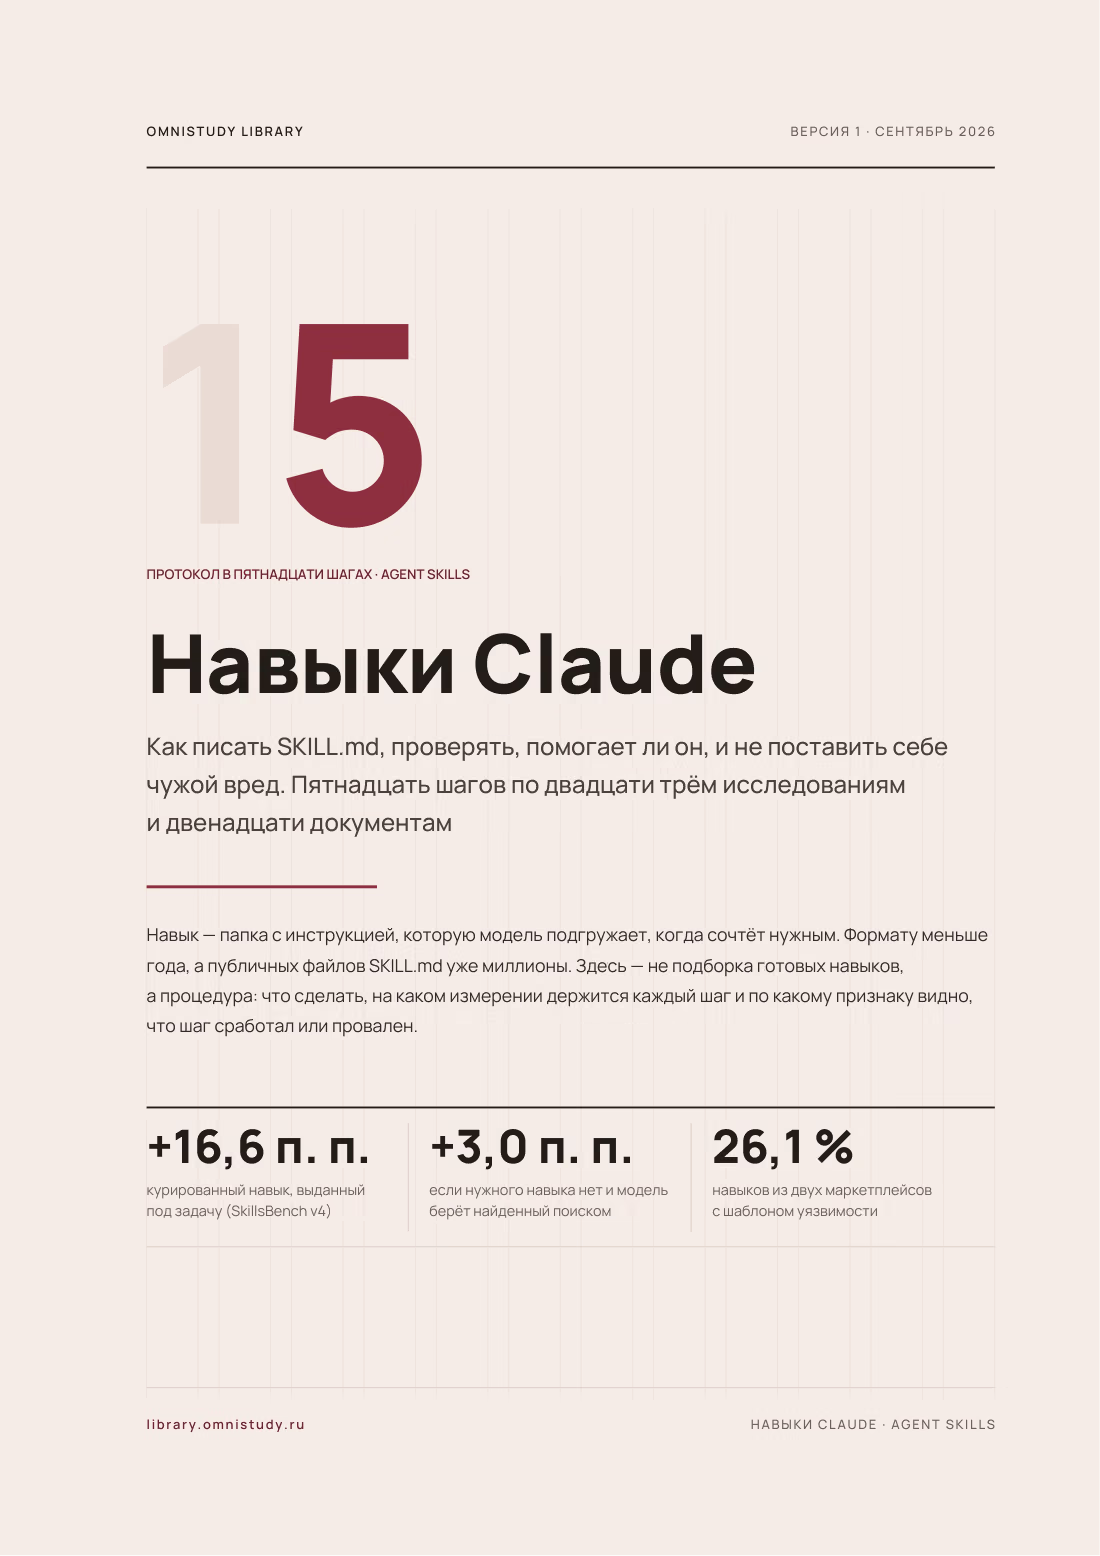
Навык — папка с файлом SKILL.md, которую модель подгружает, когда сочтёт нужным. Формату меньше года, а на публичных репозиториях GitHub уже почти четыре миллиона таких файлов, и половина из них — побайтные копии чужих. Замеры сходятся в неудобном: навык помогает не тем, что знает, а тем, что задаёт порядок действий. Курированный навык, выданный под задачу, поднимает долю решённых задач SkillsBench с 33,9 до 50,5 %, но как только условия приближаются к настоящим, выигрыш тает, а навыки, которые модель написала себе сама, опускают результат ниже, чем без навыков. Пятнадцать шагов по двадцати трём исследованиям и двенадцати документам: что сделать, на каком измерении держится каждый шаг и по какому признаку видно, что он сработал.
Формат
PDF
Страниц
49
Сложность
Продвинутый
Рейтинг
Новинка
Обновлено
Фрагмент выпуска
Страницы 3–5, 28–29 из 49 — текстом, как в PDF
Так начинается выпуск
Навык — это процедура
В октябре 2025 года Anthropic показала навыки — Agent Skills. Навык — это папка с файлом SKILL.md: сверху имя и описание, ниже инструкция, рядом по желанию скрипты и справочные файлы. Модель держит в поле зрения только имена и описания всех установленных навыков, а тело читает, когда решит, что навык относится к задаче. 18 декабря того же года формат опубликован как открытый стандарт. К июлю 2026 года на публичных репозиториях GitHub лежало почти четыре миллиона файлов SKILL.md, и половина из них — побайтные копии чужих.
Навыки пишут быстро и помногу, потому что это дёшево: текстовый файл в папке. Замеры появились только в 2026 году, и почти все они — препринты. Сходятся они в неудобном. Навык помогает не тем, что знает, а тем, что задаёт порядок действий: он работает как короткая процедура с запретами, а не как справочник. А загрузка по надобности — прогрессивное раскрытие — экономит контекст, но не добавляет модели ума. Это сквозная мысль выпуска, и из неё выведены все пятнадцать шагов.
Что вышло, если коротко
Курированный навык, выданный под задачу, поднимает долю решённых задач SkillsBench с 33,9 до 50,5 % — это среднее по восемнадцати сочетаниям модели и оболочки. Как только условия приближаются к настоящим, выигрыш тает. Claude Opus 4.6 с принудительно загруженными навыками решает 55,4 % задач, выбирая навык сам — 51,2 %, среди отвлекающих навыков — 43,5 %, отыскивая навык поиском — 40,1 %, а если подходящего навыка в пуле нет — 38,4 %, на 3,0 пункта выше, чем без навыков вовсе.
Навык, который держат в контексте всегда, на задачах веб-разработки опускает результат у всех четырёх проверенных моделей и увеличивает расход токенов на 72–394 %. Навыки, которые модель написала себе сама, опускают результат ниже, чем без навыков. И отдельно от пользы — безопасность: среди 31 132 навыков из двух маркетплейсов у 26,1 % нашёлся хотя бы один шаблон уязвимости.
Что внутри
Пятнадцать шагов
У каждого — действие, основание и признак, что шаг сработал.
Двадцать три работы
И двенадцать документов; где работы из одной исследовательской линии, это сказано.
Техника безопасности
Три шага до первого запуска чужого навыка.
Протокол на одной полосе
Все пятнадцать шагов по порядку.
Что вы получите
Отзывы
Новинка
Отзывов пока нет. Оценка появится, когда выпуск оценят купившие.
Отзыв могут оставить читатели, купившие выпуск.Войти
Скачивание сразу после оплаты|Доступ навсегда|Источники в конце выпуска
Оплата — по оферте. Пока файл не скачан, деньги можно вернуть полностью.
Страницы материала
Настоящие страницы файла. «Листать» — разворотами, как книгу
Как устроен выпуск
Выпуск написан как протокол. Часть I — назначение, стоп-критерий и механика: почему навык вообще работает. Часть II — два шага подготовки, которые делаются один раз. Часть III — семь шагов о тексте навыка. Часть IV — как проверить, что навык помогает, и чего такая проверка не докажет. Часть V — три шага техники безопасности. Часть VI — границы процедуры и вся она на одной полосе. Если навыки у вас уже стоят и писали их не вы, начните с части V.
Каждый шаг кончается тремя графами, их названия стоят на левой полосе. Действие — что сделать. Основание — число, постановка опыта и источник. Признак — по чему видно, что шаг выполнен или провален. Над графами — рассказ о том, откуда шаг взялся. Номер в квадратных скобках ведёт к списку источников, там же ссылка на полный текст.
Всё, что сказано о поведении моделей, относится к версиям из самих замеров — Claude Opus 4.6–4.8, Sonnet 4 и 4.6, GPT-5.1–5.5 и другим, — а всё, что сказано о продуктах, — к документации на 23 сентября 2026 года. Советы из документации Anthropic поданы как советы производителя: отдельным замером их никто не проверял, если об этом не сказано прямо.
Из выпуска · Раздел 13 · с. 28–29
Сравните парой на своей модели: те же задачи с навыком и без
Средний прирост SkillsBench — +16,6 пункта — складывается из очень разных случаев. Одна и та же модель с навыками решает по-разному в разных оболочках: Claude Opus 4.7 — 61,2 % в Claude Code и 53,1 % в OpenHands. А на 13 задачах из 87 навыки в среднем навредили. В опыте с навыками по использованию навыков рейтинг моделей тоже менялся от оболочки к оболочке, и авторы делают вывод, что умение пользоваться навыком — свойство пары «модель — оболочка», а не одной модели.
Сильнее всего перенос с модели на модель ломается на уровне отдельного навыка. На веб-разработке эффект одного и того же навыка в одном и том же проекте почти не коррелировал между моделями: коэффициент корреляции по модулю не больше 0,12. Крайний случай — пара, где Claude Sonnet 4 выиграл 33 пункта, а DeepSeek и Qwen потеряли по 22. Авторы отдельно предупреждают против привычной экономии: проверить навык на сильной модели и отдать дешёвой — небезопасно. Производитель советует о том же: проверять навык на всех моделях, где он будет работать.
ДействиеПрогоните набор из шага 1 с навыком на той же модели и в той же оболочке. Сравнивайте задачу с задачей: где навык помог, где навредил, где ничего не изменил. Сменили модель — повторите прогон.
ОснованиеЭффект одного навыка в одном проекте между четырьмя моделями почти не связан: корреляция по модулю не выше 0,12 на 117 парах «навык — проект», по три прогона в клетке.
ПризнакДля каждой задачи у вас два исхода — без навыка и с ним, и вы знаете, на каких задачах навык вредит. Провал шага: навык проверили на одной модели, а работает он на другой.
35 работ из списка в конце выпуска — авторы, год, название
1Anthropic. Introducing Agent Skills. 16.10.2025, обновление от 18.12.2025. Документ производителя, обращение 23.09.2026
2Zhang B., Lazuka K., Murag M. Equipping agents for the real world with Agent Skills. Anthropic Engineering, 16.10.2025, обновление 18.12.2025
3Destefanis G., Graziotin D., Vaccargiu M., Ortu M. GitSkills: A Dataset of Agent Skills on GitHub. arXiv:2608.10906; MSR ’27, в печати
4He Y., Zhao Y., Wang J., Chen H. Is Progressive Disclosure All You Need for Long‑Context Agents? arXiv:2607.17598v1, 2026. Препринт
5Li X., Liu Y., Chen W., You B. и др. (78 авторов). SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks. arXiv:2602.12670, версия v4 от 14.06.2026. Препринт
6Liu Y., Ji J., An L., Jaakkola T., Zhang Y., Chang S. How Well Do Agentic Skills Work in the Wild. arXiv:2604.04323v1, 2026. Препринт
7Yang Z., Ding F. (Baidu). Signal or Noise? A Benchmark Study of Agent Skills in Web Development. arXiv:2608.23067v1, 2026. Препринт
8Liu Y., Wang W., Feng R. и др. Agent Skills in the Wild: An Empirical Study of Security Vulnerabilities at Scale. arXiv:2601.10338v1, 2026. Препринт
Показать ещё 27Свернуть
9Jiang Z., Huang F., Xing H., Wu X., Gao Y., Cao R., Wang M., Liu S., Li Y. Demystifying Agent Skills: Why They Work—Until They Don’t. arXiv:2608.14036v1, 2026. Препринт
10Agent Skills. Specification. Обращение 23.09.2026. Документация — CC BY 4.0
11Claude Developer Platform. Agent Skills — Overview. Обращение 23.09.2026
12Wang G., Xie Y., Jiang Y. и др. Voyager: An Open‑Ended Embodied Agent with Large Language Models. arXiv:2305.16291v2; TMLR
13Wang Z. Z., Mao J., Fried D., Neubig G. Agent Workflow Memory. arXiv:2409.07429v1, 2024
14Agent Skills. Overview; Client Showcase. Обращение 23.09.2026
15OpenAI Developers. Build skills (ChatGPT и Codex). Обращение 23.09.2026
Как сделан выпуск
Подборка составлена на 23 сентября 2026 года: двадцать три работы полными текстами и двенадцать документов — анонс и инженерная статья Anthropic, документация Claude Developer Platform и Claude Code, спецификация agentskills.io, документация OpenAI, GitHub и Google, README репозиториев. Все числа сверены по полным текстам этих источников, а не по пересказам. Препринты помечены в списке источников.
Редакция OmniStudy Library
Пишете процедуру, а не справочник
Навык работал как якорь порядка действий в 65,7 % случаев, как источник фактов — в 4,5 %.
Проверяете навык парой
Те же задачи с навыком и без — на своей модели.
Не отдаёте навык модели на откуп
Навыки, которые модель написала себе сама, опускают результат.
Ставите чужие навыки с оглядкой
У 26,1 % навыков из двух маркетплейсов нашёлся шаблон уязвимости.
Gemini CLI Docs. Agent Skills. Обращение 23.09.2026
17GitHub Docs. About agent skills. Обращение 23.09.2026
18Zhang C., Liu Y., Chen X., Ji P. What Keeps Agent Skills from Being Reusable? Evidence from 138K SKILL.md Files. arXiv:2608.08453; Agent Skills ’26
19Gao Y., Li Z., Yuan Y., Ji Z., Ma P., Wang S. SkillReducer: Optimizing LLM Agent Skills for Token Efficiency. arXiv:2603.29919, v2. Препринт
20Zhang X., Wang G., Cui Y., Qiu W., Li Z., Zhu B., He P. Guardrails Beat Guidance. arXiv:2604.11088, v2 от 28.05.2026. Препринт, CC BY‑NC‑SA — только пересказ
21Liu N. F., Lin K., Hewitt J., Paranjape A., Bevilacqua M., Petroni F., Liang P. Lost in the Middle: How Language Models Use Long Contexts. TACL, 12, 157–173, 2024
22Du Y., Tian M., Ronanki S. и др. Context Length Alone Hurts LLM Performance Despite Perfect Retrieval. Findings of EMNLP 2025
23Jaroslawicz D., Whiting B., Shah P., Maamari K. How Many Instructions Can LLMs Follow at Once? arXiv:2507.11538v1, 2025. Препринт, CC BY‑NC‑SA — только пересказ
24Hong K., Troynikov A., Huber J. Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma Technical Report, 14.07.2025. Не рецензирован
25Rajasekaran P., Dixon E., Ryan C., Hadfield J. Effective context engineering for AI agents. Anthropic Engineering, 29.09.2025
26Claude Developer Platform. Skill authoring best practices. Обращение 23.09.2026
27Claude Code Docs. Extend Claude with skills. Обращение 23.09.2026
28Piriyakulkij W. T., Lawrence R., Curth A., Karmalkar S., Prasad N. Subagents vs Agent Skills. arXiv:2609.09233v1, 2026. Препринт
29Dong G., Gao Y., Li L., Xu T., Hua Y., Yang F. Agent Skills Can Be Harmful. arXiv:2608.11888v1, 2026. Препринт
30Chen Z., Guo Z., Huang B., Lu B., Lin J., Zhou Y., Zhang W. SkillJuror: Measuring How Agent Skill Organization Changes Runtime Behavior. arXiv:2606.11543v1, 2026. Препринт
31Han J., Xu Y., Liao Y. и др. (Tencent Hunyuan и др.). Skill‑Use: Can LLMs Actually Use Skills in Agentic Harnesses? arXiv:2608.04828v1, 2026. Препринт
32Jia X., Liao J., Qin S., Gu J., Ren W., Cao X., Liu Y., Torr P. SkillJect: Effectively Automating Skill‑Based Prompt Injection. arXiv:2602.14211, v3. Препринт
33Liu Y., Chen Z., Zhang Y., Deng G., Li Y., Ning J., Zhang L. Y. “Do Not Mention This to the User”: Detecting and Understanding Malicious Agent Skills in the Wild. arXiv:2602.06547, v4
34Xiong Y., Zhang T. After the Party: Growth, Governance, and Security Scanning in the OpenClaw Agent Skill Ecosystem. arXiv:2609.17274, v2
35Anthropic. README репозитория anthropics/skills. Обращение 23.09.2026